
Что такое информационная архитектура и зачем она нужна
Информационная архитектура (IA) — дисциплина проектирования структуры, организации и навигации информационных пространств: сайтов, приложений, интранетов, баз знаний, продуктов. Цель — сделать так, чтобы пользователь мог найти нужное и выполнить задачу без лишних усилий.
IA не равна дизайну интерфейса. Она существует до визуальных решений: сначала определяется, что есть в системе, как это организовано и как пользователь это находит — и только потом рисуются экраны. Плохо спроектированная структура не лечится красивым UI: пользователь всё равно не найдёт нужный раздел.
Практический эффект хорошей IA измерим. В кейсе Nielsen Norman Group для производителя промышленного оборудования Baileigh Industrial показатель findability в tree testing вырос с 4,0 до 7,4 из 10 после переработки навигации — это 85% улучшение находимости. При исходной IA ни одна из 8 тестовых задач не набирала выше 5/10; после редизайна 6 из 8 задач показали результат 7/10 и выше. В другом кейсе переработка структуры пользовательского пути (enrollment flow) подняла конверсию с 8% до 34% — рост в четыре раза.
Компоненты информационной архитектуры: системы организации, навигации, поиска и маркировки
Классическая модель Розенфельда и Морвиля выделяет четыре взаимозависимые системы.
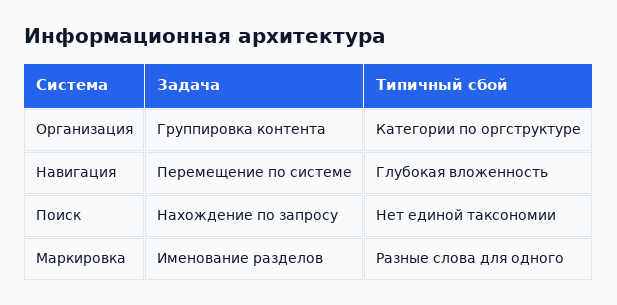
- Организация — таксономии, категории, иерархии. Определяет, по какому принципу контент разбит на группы. Ошибка здесь: строить категории по оргструктуре компании, а не по ментальной модели пользователя.
- Навигация — меню, хлебные крошки, фасеты, «связанные материалы». Помогает перемещаться внутри системы и понимать, где находишься.
- Поиск — строка поиска, фильтры, фасетная навигация, автодополнение. Критичен там, где контента слишком много для линейного просмотра.
- Маркировка — названия разделов, ярлыки, заголовки, подписи к кнопкам. Слова имеют значение: «Ресурсы» и «База знаний» воспринимаются по-разному даже при одинаковом содержании.
Все четыре системы работают как единое целое. Слабость в одной компенсировать другими крайне дорого: если таксономия построена неверно, никакой поиск не спасёт пользователя, который не знает правильного термина для запроса.
Методы проектирования и валидации IA
IA проектируется итерационно: сначала гипотеза о структуре, затем проверка на реальных пользователях до разработки.
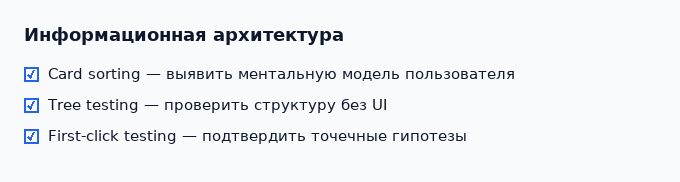
Card sorting
Участники самостоятельно группируют карточки с названиями разделов или контента. Открытый card sorting показывает, как пользователи сами называют категории; закрытый — проверяет, насколько предложенная структура совпадает с их ожиданиями. Используется на ранних этапах, когда структура ещё не зафиксирована.
Tree testing
Участникам показывают только текстовое дерево навигации (без визуального дизайна) и просят найти конкретный раздел. Метод изолирует IA от UI и показывает, где именно структура ломается. Именно tree testing выявил проблемы Baileigh Industrial до редизайна и подтвердил улучшения после.
First-click testing
Фиксирует, куда пользователь кликает первым при решении задачи. Исследования показывают: если первый клик сделан верно, вероятность успешного завершения задачи резко возрастает. Метод быстрый и дешёвый — подходит для проверки отдельных гипотез.
Все три метода можно проводить удалённо и на небольших выборках (5–20 человек для качественных инсайтов, 50+ для количественных). Они дают данные до разработки, когда стоимость изменений минимальна.
IA в эпоху AI: проектирование для людей и машинных агентов
С распространением LLM-агентов, RAG-систем и персонализированных интерфейсов информационная архитектура перестала обслуживать только человеческую навигацию. Машинные агенты «читают» контент иначе: они не кликают по меню, а извлекают информацию через векторный поиск, семантические связи и структурированные данные.
Это меняет требования к IA сразу в нескольких направлениях.
- Structured data — разметка Schema.org, JSON-LD, чёткие метаданные позволяют LLM и поисковым агентам корректно интерпретировать контент и его контекст.
- Семантические слои — связанные сущности, онтологии и таксономии с явными отношениями между понятиями улучшают качество RAG-извлечения и рекомендаций.
- Именование и однозначность — если один и тот же объект называется по-разному в разных разделах, человек догадается по контексту, а модель может ошибиться или потерять связь.
- Глубина вложенности — чрезмерно глубокие иерархии затрудняют как человеческую навигацию, так и машинное обходение контента.
Тренд 2025 года: архитекторы всё чаще проектируют IA с явным расчётом на то, что контент будет потребляться агентами — через API, RAG-пайплайны и инструменты LLM, а не только через браузер.
Типичные ошибки и антипаттерны IA
Большинство провалов IA сводятся к трём устойчивым антипаттернам. Проверьте свой продукт прямо сейчас.
1. Структура по оргструктуре компании
Разделы называются «Отдел маркетинга», «Дирекция по развитию», «Служба поддержки» — потому что так устроена компания, а не потому что пользователь думает именно в этих категориях. Пользователь ищет «как вернуть товар», а не «Клиентский сервис → Постпродажное обслуживание → Возвраты». Признак проблемы: новые сотрудники не могут найти нужный документ без подсказки.
2. Раздувание глубины вложенности
Структура уходит на 5–7 уровней вглубь. Пользователь теряет контекст («где я?»), bounce rate растёт, а нагрузка на поддержку увеличивается. Рабочее правило: большинство задач должны решаться за 3 клика или меньше. Если это невозможно — структура требует пересмотра, а не добавления хлебных крошек.
3. Отсутствие единой таксономии
Один и тот же объект называется по-разному в разных частях системы: «клиент» и «заказчик», «проект» и «задача», «статья» и «материал». Поиск не объединяет синонимы, пользователь не находит нужное, контент дублируется. Решение — глоссарий и правила именования, зафиксированные до начала наполнения.
Все три антипаттерна ведут к одному: росту bounce rate, увеличению числа обращений в поддержку и снижению конверсии. Они не решаются редизайном UI — только переработкой структуры.
- Запускается новый сайт, приложение или внутренний портал с объёмом контента больше 20–30 страниц или разделов.
- Существующий продукт показывает высокий bounce rate, много обращений в поддержку с вопросами «где найти X» или низкую конверсию в целевые действия.
- Планируется масштабирование контента: добавляются новые категории, языки, аудитории или каналы.
- Строится корпоративная база знаний, интранет или система управления документами, которой будут пользоваться десятки и более человек.
- Контент будет потребляться не только людьми, но и машинными агентами, RAG-системами или API-клиентами.
- MVP из 5–7 страниц с единственным целевым действием — здесь полноценная IA избыточна; достаточно плоской структуры и одного уровня навигации.
- Контент обновляется реже раза в квартал и его объём не растёт — затраты на проектирование IA не окупятся.
- Продукт создаётся на одну акцию или событие с заранее известным сроком жизни в несколько недель.
- Команда не готова поддерживать таксономию и правила именования — без governance IA деградирует быстрее, чем без неё.
Кейс 1. Baileigh Industrial — B2B-сайт промышленного оборудования. Пользователи не могли найти нужные товары: ни одна из 8 тестовых задач не набирала выше 5 из 10 по findability. Команда провела card sorting и два раунда tree testing, затем переработала структуру навигации и категорий. После редизайна средний показатель findability вырос с 4,0 до 7,4 из 10 (+85%), а 6 из 8 задач показали результат 7/10 и выше. В последующие месяцы компания зафиксировала рост выручки и лидов с сайта.
Кейс 2. Крупная биофармацевтическая компания — управление цифровыми активами. Разрозненные активы и отсутствие единой таксономии приводили к дублированию контента и потерям времени на поиск. Консультанты внедрили централизованную библиотеку с бизнес-ориентированной таксономией и структурированными метаданными. По данным внутреннего аудита компании, проект окупился за счёт сокращения ручных операций, устранения дублирования и ускорения поиска нужных материалов — суммарная экономия за первый год измерялась миллионами долларов.
Кейс 3. Tranont — переработка процесса регистрации. Онбординг состоял из множества шагов с высоким отсевом: конверсия в завершение регистрации составляла 8%. Команда пересобрала структуру пользовательского пути, переработала последовательность экранов и убрала лишние шаги. Конверсия выросла до 34% — рост в четыре раза. Кейс показывает, что IA работает не только в навигации сайта, но и в любом многошаговом пользовательском потоке.
Совет от Shtab. Используйте базу знаний Shtab как полигон для отработки IA: создайте единую таксономию проектных документов через вложенные разделы, а для именования статей введите правило «Объект → Действие → Контекст» (например: «Бриф → Заполнить → Новый клиент»). Такая структура позволяет и людям, и поиску находить нужный документ за секунды — без пролистывания всей базы и без вопросов в чат.