С 27 апреля по 3 мая 2026 года на платформе GitBook ИИ-агенты обеспечили 51,8% всех осмысленных прочтений документации. Не-человеческий трафик в этот период дал 63,8% просмотров страниц. Для сравнения: в январе 2025 года доля ИИ-трафика не превышала 10%. Роль главного читателя корпоративной документации постепенно переходит от сотрудника к модели.
Вот что эта модель там находит. Тест 40 крупных сайтов документации и 373 страниц дал медианную оценку «готовности к работе с агентами» 5,7 из 10 баллов, и только семь сайтов из сорока набрали 8,0 и выше, по данным исследования DiscoverCX. Большинство баз знаний технически существуют, но не готовы отдать агенту извлекаемый ответ.
Переводя на язык проектного офиса: компания подключает ИИ-агента к трекеру и регламентам, ожидая сократить время на поиск информации. А получает либо «не нашёл», либо уверенный ответ не по делу. Модель здесь виновата редко. Виновата структура документа, который она читала.
Дальше — девять требований к документу базы знаний, который агент сможет использовать, разбор «было/стало» на реальном регламенте и схема, как встроить эти требования в ежедневную работу с документами, а не превращать их в разовую уборку перед внедрением ИИ.
Агенты читают вашу базу знаний чаще сотрудников — и видят там пустые страницы
Доля ИИ-трафика на сайтах документации
Объём документации тут почти ни при чём. Компании годами копят регламенты, инструкции, протоколы встреч, счёт идёт на сотни страниц. Беда в том, что значительная часть этого объёма физически не содержит извлекаемого ответа.
На корпусе из 220 страниц справки и документации 43 страницы отдали менее 100 слов текста, а 15 не отдали ничего: сервер корректно отвечает кодом 200, но содержательного текста в разметке страницы нет, показало исследование Lantad. Человеку такая страница может казаться нормальной: заголовок на месте, структура привычная. Для агента, который разбирает текст на смысловые фрагменты, там пусто.
У корпоративных баз знаний причины обычно одни и те же. Контент собирается на интерактивных совещаниях и дальше живёт в головах участников, а на странице остаётся протокол без выводов. Смысл процесса закодирован в схеме или скриншоте, подпись к которым никто не написал. Инструкция оформлена таблицей, где заголовки колонок потерялись при копировании из другого файла. Регламент согласования лежит PDF-вложением в задаче: для человека это клик, для агента часто непроходимый барьер. Когда регламенты, инструкции и протоколы разбросаны между диском, почтой и чатами, собрать их в одном месте становится отдельной задачей ещё до того, как встанет вопрос о подключении агента.
Наличие документа и возможность извлечь из него ответ — вещи разные. Страница может существовать годами и при этом оставаться бесполезной для агента, который работает не с документом целиком, а с его фрагментами. Агент не достраивает контекст, который сотрудник берёт из опыта работы в компании. Он не знает, что «обычно так не делают», что «на самом деле решает другой человек» или что «актуальна вторая версия файла, а не та, что открылась первой в поиске». Контекст, который не записан словами в теле документа, агент с высокой вероятностью не учтёт.
Что именно ломается: восемь типов «слепых зон» в регламентах
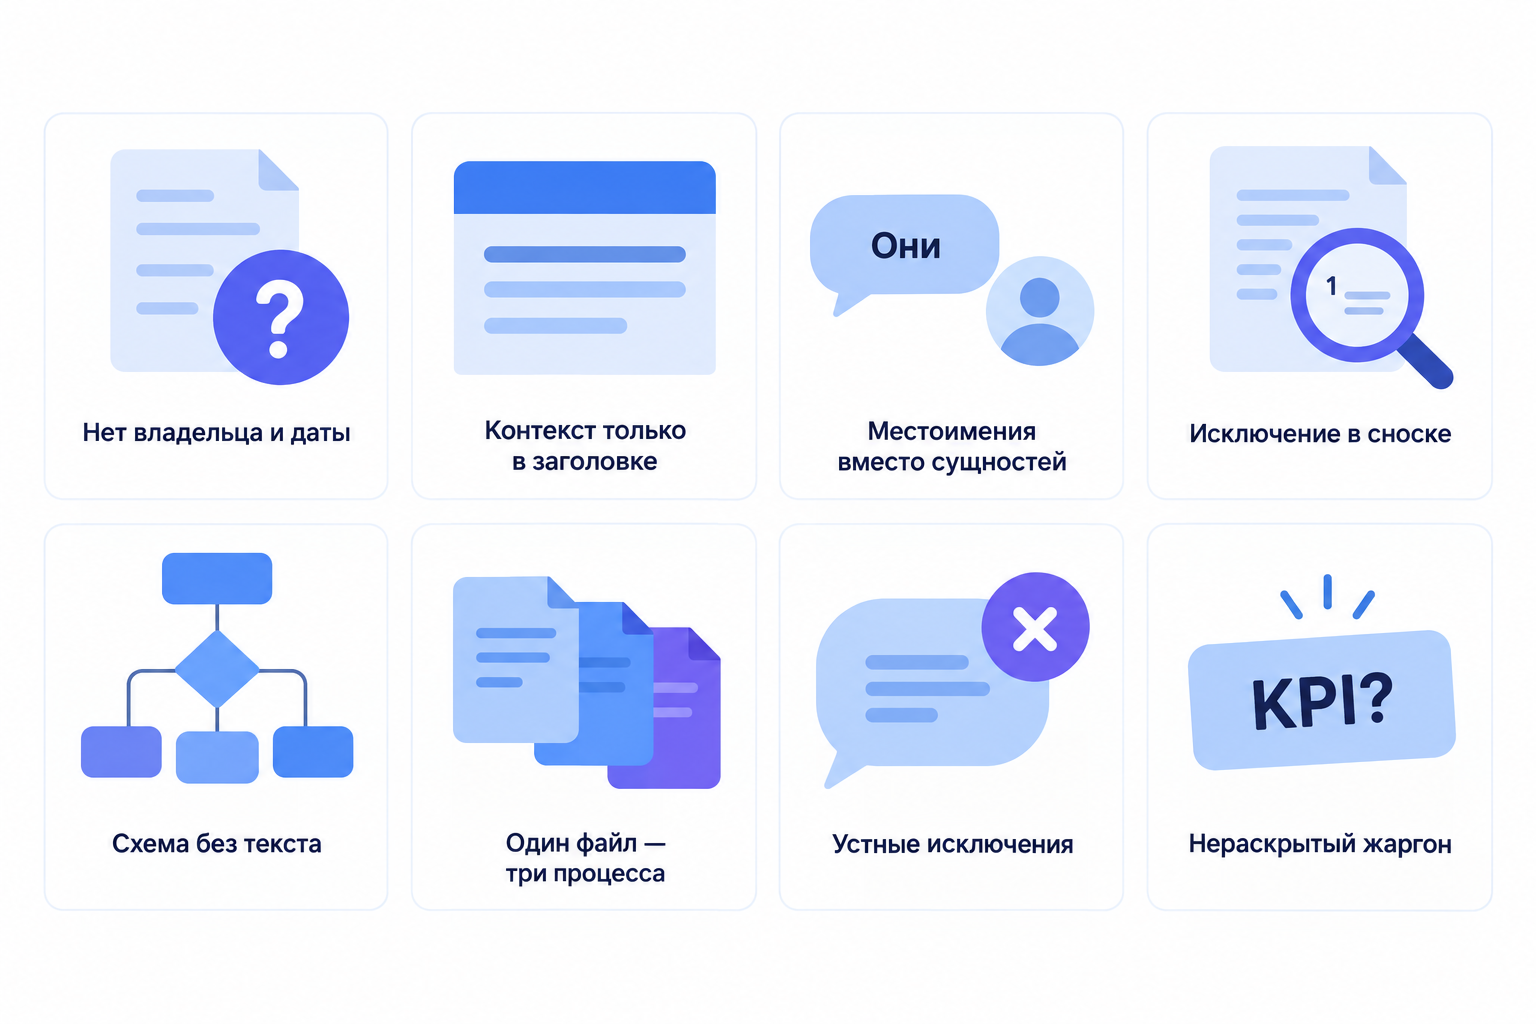
Агент спотыкается не о сложность темы. Он спотыкается о неявность: отсутствие субъекта действия, даты, границ применимости.
Первая группа проблем связана с происхождением текста. У документа нет владельца и даты пересмотра, поэтому агент находит две страницы с похожими формулировками и не может выбрать, какая из них действует сейчас. Рядом с этим живёт случай, когда контекст вынесен в заголовок, а в теле его нет: строка «Шаг 3. Согласовать» не отвечает, что согласовать и с кем. Сюда же относятся местоимения вместо сущностей. Фраза «он отправляет это туда» грамматически корректна и семантически пуста.
Вторая группа — про то, где спрятан смысл. Главное правило набрано в тексте, а исключение из него уехало в сноску мелким шрифтом, которую парсер может не увидеть. Блок-схема процесса стоит без текстового описания рядом, и для агента это картинка без содержания. Один файл описывает сразу три процесса, агент выдёргивает фрагмент из середины и теряет, к какому сценарию тот относится.
Третья группа — расхождение документа и практики. Часть исключений существует только устно: «у нас так больше не делают, но в регламенте осталось». Внутренний жаргон ни разу не раскрыт полным текстом, ни в начале документа, ни в глоссарии, и аббревиатура остаётся для модели набором букв.
Из этих восьми болячек выводится ровно обратный список: требования, по которым документ можно проверить ещё до публикации.
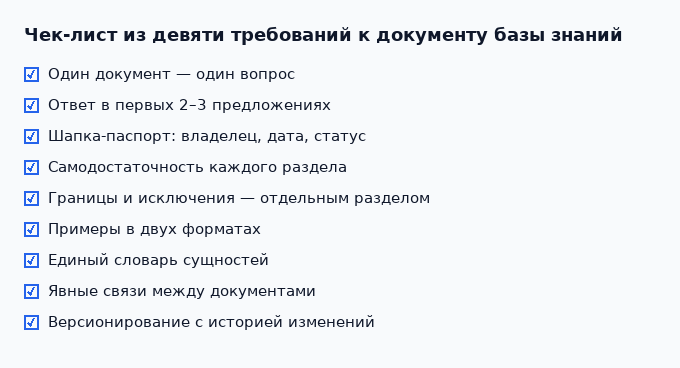
Чек-лист: 9 требований к документу базы знаний, который поймёт ИИ-агент
Машиночитаемость — это дисциплина в структуре текста и в формулировках. Соблюдать её нужно на этапе написания, а не чинить задним числом после жалоб на агента.
- Один документ — один вопрос. Заголовок страницы повторяет формулировку живого запроса сотрудника, а не название процесса из внутренней номенклатуры. Не «Регламент СОГ-14», а «Как согласовать договор с подрядчиком». Агент ищет совпадение по смыслу запроса, и код документа, который сотрудник никогда не наберёт в поиске, ему ничем не поможет.
- Ответ в первых двух-трёх предложениях. Условия, исключения и детали идут дальше. ИИ-инструменты работают с небольшими фрагментами текста и возвращают их по смысловой близости к запросу, поэтому выигрывают документы с самодостаточными блоками в начале, а не с растянутым вступлением.
- Шапка-паспорт документа: владелец, дата последнего пересмотра, область применения и статус (действует, заменён, черновик). Практики, которые собирают базы знаний под агентов, требуют, чтобы каждый извлечённый фрагмент приходил вместе с источником, датой и владельцем, иначе модель не закрывает вопрос о происхождении ответа. Как именно выстраивается такая разметка документов для модели, подробно разобрано в материале про LLM-ассистента для управления проектами.
- Самодостаточность каждого раздела. Любой подзаголовок H2 должен читаться вне контекста остального документа, а субъект и объект действия повторяются в каждом разделе. Ссылка «как сказано выше» для агента, который работает с фрагментом, бесполезна.
- Границы и исключения — отдельным разделом. Назовите его явно: «Когда это правило не применяется». В индексе из 30 заметных агентных систем, оценённых по 45 параметрам, разработчики подробно описывают возможности и сценарии применения, а ограничения, риски и проверки безопасности раскрывают заметно хуже, показал The 2025 AI Agent Index. Та же асимметрия воспроизводится во внутренних регламентах: раздел «как надо делать» написан подробно, раздел «где нельзя» отсутствует.
- Примеры в двух форматах: текстовое описание шага плюс машиночитаемый фрагмент — таблица значений, пример заполненного поля, образец текста письма. Скриншот остаётся дополнением к тексту и заменить его не может.
- Единый словарь сущностей. Если в трекере поле называется «Цели компании», в регламенте оно называется точно так же. Агент сопоставляет текст документа с данными системы по совпадению названий, и расхождение формулировок («цели» в одном месте, «задачи верхнего уровня» в другом) рвёт эту связь.
- Явные связи между документами. Ссылка с пояснением, что по ней находится, вместо безликого «подробнее здесь». Для вопросов про отношения между сущностями (кто за что отвечает, что от чего зависит) плоский текст работает плохо, нужна карта связей. Принцип похож на тот, что лежит в основе метода Zettelkasten: ценность заметки часто не в ней самой, а в явных связях с другими.
- Версионирование с историей изменений. Короткий журнал в конце документа: дата, что изменилось, кто утвердил. Именно это позволяет агенту ответить «правило действует с такого-то числа», а не выдать устаревшую редакцию за актуальную.
Проверка занимает минуту. Задайте агенту пять реальных вопросов сотрудников по проверяемому документу и посмотрите, цитирует ли он нужный абзац. Если он цитирует соседний абзац или вовсе соседний документ, причина в структуре текста: модель здесь ни при чём.
Плохой и хороший регламент: разбор на одном документе
Регламент согласования договора: было и стало
Разница видна не на уровне целого свода правил, а буквально на трёх абзацах. Возьмём сквозной пример: регламент согласования договора с подрядчиком.
Было: «Договор согласуется в установленном порядке. При необходимости привлекается юрист. Сроки — разумные. Ответственный — руководитель направления.»
Разбираем по пунктам чек-листа. Нет субъекта действия: кто именно инициирует согласование. Нет цифр, потому что «разумные сроки» ничего не говорят ни человеку, ни агенту. «При необходимости» — условие без критерия: кто решает, нужен юрист или нет. Нет даты пересмотра и нет границ применимости, так что непонятно, о каких суммах и типах договоров идёт речь.
Как мог бы выглядеть переписанный регламент. Заголовок меняется на «Как согласовать договор с подрядчиком на сумму до 500 000 ₽». Первый абзац сразу даёт прямой ответ: кто инициирует процесс, какие шаги нужно пройти и какой срок отведён на каждый. Дальше идёт шапка-паспорт с владельцем документа и датой последнего пересмотра. Отдельным блоком стоит раздел «Когда правило не применяется»: суммы выше порога, валютные контракты, типовые оферты, для них действуют другие документы. В конце — короткий журнал изменений.
Разница проявляется в ответе агента. На версии «было» он пересказывает текст регламента почти дословно, и из этого пересказа непонятно, что конкретно делать. На переписанной версии он называет конкретного ответственного, точный срок каждого шага и честно уточняет, если вопрос сотрудника выходит за пределы указанного порога суммы.
Почему больше документации не решает проблему
Естественная реакция команды после первых промахов агента: «давайте задокументируем всё подробнее». Чаще всего это ухудшает качество ответов. Модель выбирает фрагмент текста по смысловой близости к запросу; ваше внутреннее представление о том, какой документ актуален, на этот выбор не влияет.
Если в базе лежат три версии одного и того же — регламент 2023 года, его черновая правка и «временная инструкция на период перехода», — агент с высокой вероятностью найдёт все три. И выдаст наиболее текстуально похожий на запрос фрагмент, не обязательно тот, который действует сейчас.
Привычная офисная культура «ничего не удаляем, вдруг пригодится» здесь играет против вас: архивация устаревших документов и явная пометка «заменён документом X» дают больший прирост качества ответов, чем написание новых статей базы знаний. Чистка часто полезнее пополнения.
Похожая логика касается технических надстроек. Файл llms.txt — карта документации, которую компании выкладывают специально для языковых моделей, чтобы те быстрее находили нужные разделы сайта. Такие решения помогают только тем командам, у которых страницы уже содержательны. Если страницы пусты или противоречат друг другу, llms.txt и подобные машинные выгрузки быстрее приводят агента к странице, на которой нечего цитировать.
Третий слой — цена ошибки выросла. Неточность в регламенте раньше отлавливал здравый смысл сотрудника, который читал документ сам и сверял его с реальностью. Агент эту ошибку не фильтрует: он воспроизводит её в сотне похожих задач подряд, причём с уверенной интонацией.
Отчёт Bain о фундаменте для агентного ИИ формулирует это так: успех агентных систем зависит от того, насколько доменные знания компании (документация по продукту, бизнес-логика, данные о процессах) сделаны обнаружимыми и доступными для агента. Объём накопленного текста сам по себе ничего не решает. Решают структура и отсутствие противоречий.
Кейс: 8 месяцев документации — за 6 недель
Когда знания структурированы и доступны агенту для извлечения, документирование перестаёт быть проектом на полгода.
Банк, о котором пишет CGI в разборе кейса, оценивал ручную подготовку документации по одному из банковских приложений примерно в 8 месяцев. Агентный подход проанализировал кодовую базу и артефакты проекта и сгенерировал техническую, интерфейсную и процессную документацию сразу для технических и для бизнес-читателей. Результат: более 95% принятия документов с первого прохода, срок подготовки сократился с 8 месяцев до 6 недель, трудозатраты снизились более чем на 80%.
Второй пример ближе к повседневной работе проектных команд, но без цифр. Платформа SmartCat с агентом ACE собирает данные из уже работающих систем компании, сводит их в единую базу знаний и обновляет только изменившиеся фрагменты, а не документ целиком; эффект в опубликованном кейсе описан качественно, без финансовых метрик.
Третий пример даёт более жёсткую цифру в той же логике. В пилоте для глобальной фармацевтической компании ИИ-агент формировал черновики документации по SDLC (жизненному циклу разработки ПО) из тикетов Jira, локальных файлов и обычного текста, а специалисты переходили от написания к проверке и утверждению. Трудозатраты на черновую подготовку документации сократились примерно на 90%.
Во всех трёх случаях выигрыш дала не модель сама по себе, а то, что знания о проекте лежали в системах, откуда их можно извлечь по структуре, а не в головах сотрудников и в переписке, которую никто не перечитывает.
Как встроить это в процесс документирования, а не в разовую уборку
Требования к документам работают только тогда, когда привязаны к рабочему циклу задач. Ежегодная инвентаризация базы знаний перед внедрением нового инструмента проигрывает постоянному контуру документирования.
Первый контур — точка создания. Документ рождается из задачи: закрыли эпик, на выходе появилась страница с описанием решения. Правило «нет страницы — задача не закрыта» на практике работает лучше, чем отдельный квартальный спринт, посвящённый документации. В Shtab регламенты и материалы живут страницами рядом с проектами и задачами, поэтому не приходится переключаться между трекером и отдельным хранилищем, собирая разрозненные файлы из переписки и облачных дисков.
Второй контур — шаблон вместо инструкции про шаблон. Форма новой страницы сразу содержит поля паспорта: владельца, дату, область применения, статус, журнал изменений. Если этих полей в шаблоне нет, паспорт документа заполняют единицы, какой бы хорошей ни была сама идея.
Третий контур — пересмотр. Срок жизни документа стоит задавать при создании: регламенты согласований живут полгода, инструкции по конкретным инструментам устаревают за три месяца. Владельцу документа ставится повторяющаяся задача: подтвердить актуальность или перевести документ в архив.
Четвёртый контур — проверка. Раз в месяц имеет смысл прогонять 10–15 типовых вопросов сотрудников через агента и фиксировать, какие документы он цитирует неправильно. Такая проверка является дешёвым аналогом внешних замеров «готовности к работе с агентами», которые исследователи делают по сотням страниц публичной документации.
В Shtab AI устройство агента отражает эту логику напрямую. У агента есть специализированные роли (менеджер проекта, исследователь, OKR-эксперт, аналитик, HR, разработчик, маркетолог) и режим планирования, когда перед сложной задачей он сначала задаёт уточняющие вопросы и только потом формирует пошаговый план действий. Роль задаёт, какие документы агент будет искать первыми. Это оборотная сторона седьмого пункта чек-листа: если словарь сущностей в регламенте и в продукте расходится, даже правильно выбранная роль не поможет, нужный документ просто не найдётся по совпадению терминов.
Отдельно о том, что обычно волнует руководителей при подключении ИИ к внутренним документам. Shtab AI в режиме агента может создать страницу, исправить текст на существующей, обработать загруженный документ и превратить его в набор задач, создать и декомпозировать проект, изменить описание или сроки карточек, отправить комментарий или подготовить отчёт. При этом агент работает от имени сотрудника, который его запустил, и видит ровно те проекты, страницы и цели, к которым у этого сотрудника есть доступ: закрытые данные через него не утекут. Действия агента можно подтверждать вручную или разрешить автономную работу в зависимости от уровня доверия команды. История чатов сохраняется, а для компаний с повышенными требованиями к конфиденциальности доступно подключение к локальной модели.
Мнение практика: что ломается первым при подключении агента к базе знаний
Первым рушится доверие команды к ответам агента, ещё до того, как успевает сломаться сам поиск.
По опыту компаний, подключавших ИИ-агента к внутренней базе знаний, первые одну-две недели сотрудники проверяют вручную буквально каждый ответ. Если в этот период агент дважды сошлётся на устаревший регламент, пусть даже по второстепенному вопросу, команда молча возвращается писать друг другу в чаты. Последующая чистка базы знаний доверие уже не восстанавливает, приходится ждать следующего цикла внедрения.
Практика подсказывает контринтуитивный порядок действий: сначала привести в порядок 10–15 самых запрашиваемых документов и только после этого открывать к ним доступ агенту.
Асимметрия, которая видна в прозрачности внешних агентных систем (возможности описывают подробно, ограничения гораздо реже), воспроизводится и во внутренних регламентах компаний. Источником большинства неверных ответов агента становятся именно непрописанные ограничения и исключения, а не нехватка возможностей модели. Проблема похожа на ту, что разбирается в материале о единой системе задач для бизнеса и ИТ: пока правила игры прописаны неполно, виноватым назначают инструмент, хотя дело в процессе вокруг него.
План на ближайшие три недели
План на три недели
Начинать стоит не с переписывания всей базы знаний, а с замера того, насколько плохо дело обстоит прямо сейчас.
Неделя 1, замер. Собрать 15 реальных вопросов сотрудников из рабочих чатов за последний месяц и прогнать их через агента. Зафиксировать долю ответов с правильной ссылкой на действующий документ: это стартовая точка, с которой можно сравнивать прогресс.
Неделя 2, паспорт и архив. Проставить владельца, дату пересмотра и статус у 20 самых читаемых документов. Всё, что фактически заменено более новой версией, перевести в архив с пометкой «заменён документом X»: не удаляя физически, а именно меняя статус.
Неделя 3, переписать три худших документа по чек-листу из девяти требований и повторить замер первой недели на тех же 15 вопросах.
Если компания готова к более полноценному внедрению с контрольными точками и метриками, следующий логичный шаг описан в пошаговом фреймворке внедрения ИИ-агента, рассчитанном на 12 недель до измеримого результата.
Формулировка «база знаний приведена в порядок» сама по себе ничего не измеряет. Метрика успеха одна: доля вопросов сотрудников, на которые агент отвечает с корректной ссылкой на действующий документ, а не на архивную версию двухлетней давности.
Частые вопросы
Частые вопросы
Нужно ли переписывать всю базу знаний под ИИ или хватит 20 документов?
Работает принцип Парето: начать стоит с топа реальных запросов сотрудников. 15–20 переписанных по чек-листу документов дают эффект быстрее, чем аудит всего архива.
Что лучше для агента: страницы в трекере или файлы в облаке?
Место хранения вторично, решает извлекаемость текста. PDF без текстового слоя или схема без подписей остаются тёмной зоной независимо от места хранения.
Что такое llms.txt и нужен ли он внутренней базе знаний?
Это файл-карта документации для языковых моделей, актуальный прежде всего для публичных сайтов. Для внутреннего контура важнее структура страниц и права доступа.
Как часто пересматривать документы?
Срок стоит привязывать к типу документа: регламенты согласований живут около полугода, инструкции по инструментам устаревают за три месяца.
Безопасно ли давать агенту доступ к регламентам компании?
Агент работает в рамках прав доступа запросившего сотрудника, закрытые страницы не раскрываются, действия можно настроить на ручное подтверждение.
Кто должен отвечать за базу знаний: руководитель проектов, HR или отдельная роль?
У каждого документа должен быть владелец-человек с фамилией в журнале изменений. Координацию обычно ведёт проектный офис, но актуальность подтверждает тот, кто реально разбирается в теме.
Нужно ли переписывать всю базу знаний под ИИ или хватит 20 документов?
Работает принцип Парето по частоте обращений: начинать стоит с топа реальных запросов сотрудников, полный аудит всех документов подряд здесь избыточен. На практике 15–20 переписанных по чек-листу документов, которые спрашивают каждую неделю, дают заметный эффект быстрее, чем попытка охватить весь архив сразу.
Что лучше для агента: страницы в трекере или файлы в облаке?
Место хранения вторично: решающим фактором является извлекаемость текста. Проблема начинается там, где документ оформлен PDF-вложением без текстового слоя или где смысл процесса закодирован в схеме без подписей. Такие форматы остаются тёмной зоной независимо от того, где они физически лежат.
Что такое llms.txt и нужен ли он внутренней базе знаний?
Это файл-карта документации, который помогает языковым моделям быстрее находить разделы сайта. Он актуален прежде всего для публичных сайтов документации, которые читают внешние модели. Для внутреннего контура важнее структура самих страниц и права доступа: именно они определяют, что агент способен найти и процитировать.
Как часто пересматривать документы?
Срок пересмотра стоит привязывать к типу документа, а не вводить один общий интервал на всю базу. Регламенты согласований живут около полугода, инструкции по конкретным инструментам устаревают за три месяца, потому что сам инструмент меняется чаще. Дату следующего пересмотра проще проставить сразу при создании страницы.
Безопасно ли давать агенту доступ к регламентам компании?
Агент работает от имени запросившего сотрудника и строго в рамках его прав доступа: закрытые проекты и страницы через него не раскрываются. Действия можно настроить на ручное подтверждение или разрешить автономную работу, история чатов сохраняется, а для компаний с повышенными требованиями к конфиденциальности доступно подключение к локальной модели без выхода данных за пределы внутреннего контура.
Кто должен отвечать за базу знаний: руководитель проектов, HR или отдельная роль?
У каждого документа должен быть владелец-человек, а не отдел: в журнале изменений стоит конкретная фамилия. Общая координация процесса документирования обычно ложится на руководителя процесса или проектный офис, но подтверждать актуальность регламента должен тот, кто в нём реально разбирается, иначе формальный куратор раз в квартал проставляет новую дату, не читая текст.